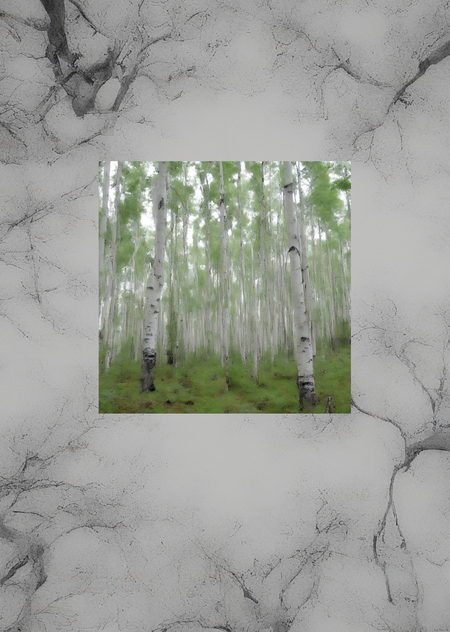
LUMORA — эксперимент по обучению генеративной модели авторскому визуальному стилю, основанному на приглушённых цветах, мягком расфокусе и ощущении ускользающей реальности.
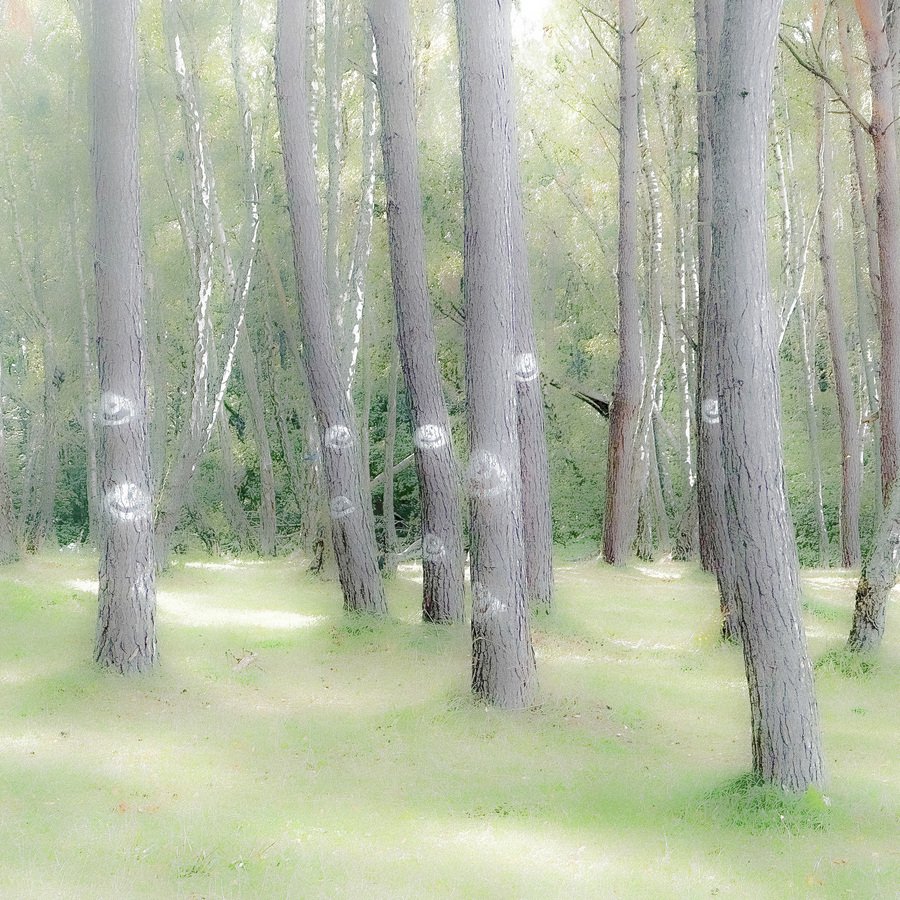
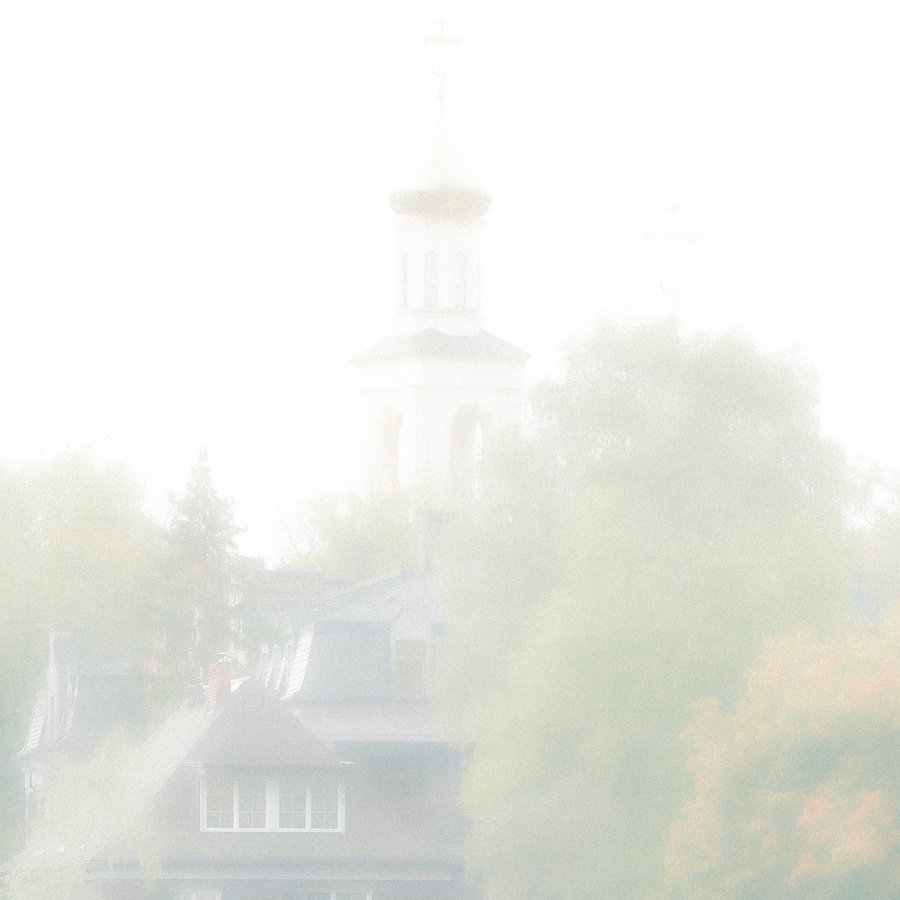
Иногда фотография воспринимается не как документальная фиксация момента, а как некое воспоминание о нём. Детали теряют чёткость, контуры растворяются в тумане, свет становится мягче, а привычные места приобретают почти нереальное ощущение. В основе LUMORA лежит идея визуальной памяти — тонкого баланса между фотографией и воспоминанием.Для эксперимента я собрала датасет из собственных фотографий природы и архитектуры, обработала их в одном стиле: приглушённые оттенки, мягкие переходы между светом и тенью, зернистость. Цель проекта — создать инструмент, который сможет переносить эти особенности на новые сюжеты, сохраняя узнаваемый характер.
Исходные изображения
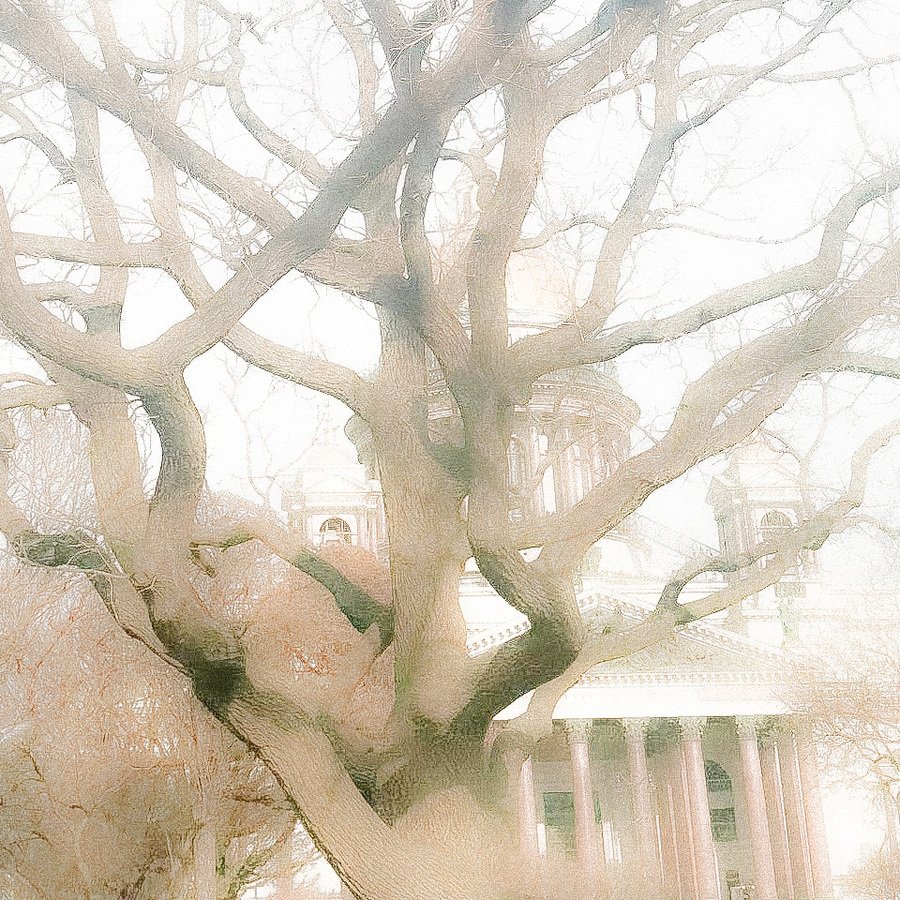
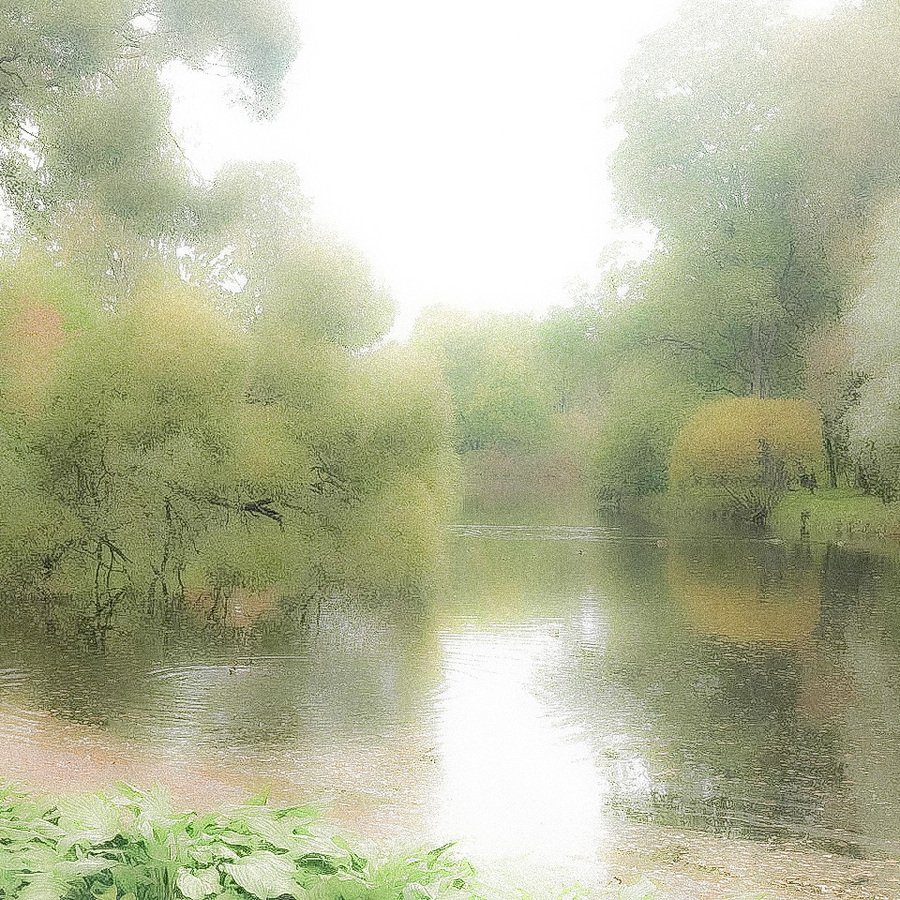
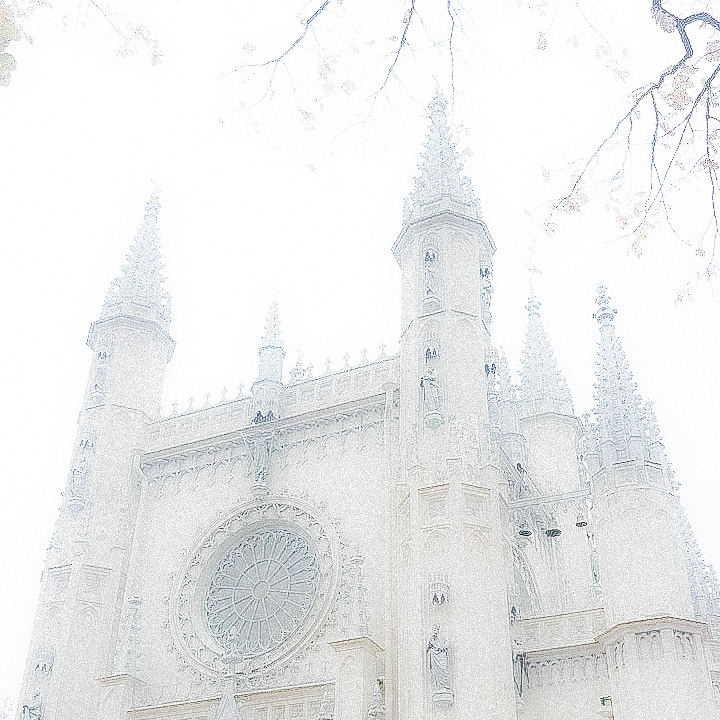
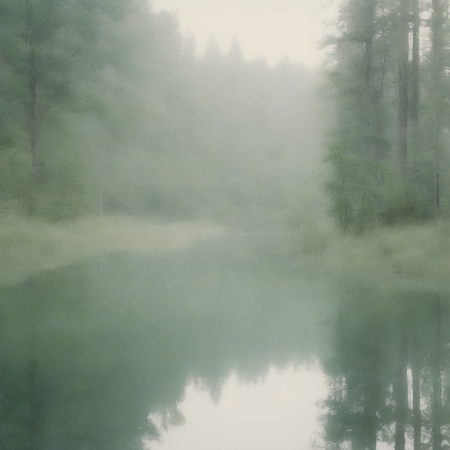
Серия сгенерированных изображений
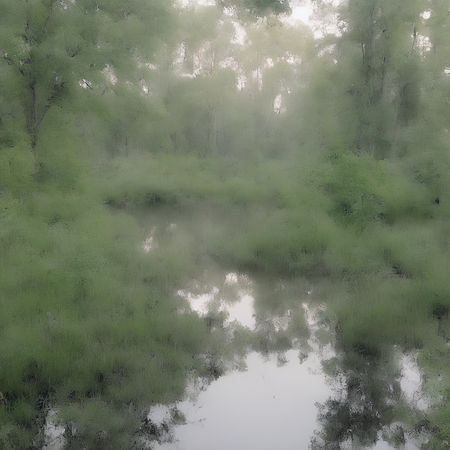
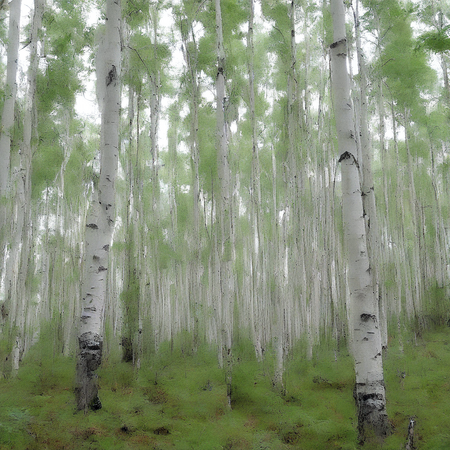
LUMORA style, a quiet pond surrounded by trees at dawn / LUMORA style, slender birch trunks in a pale forest
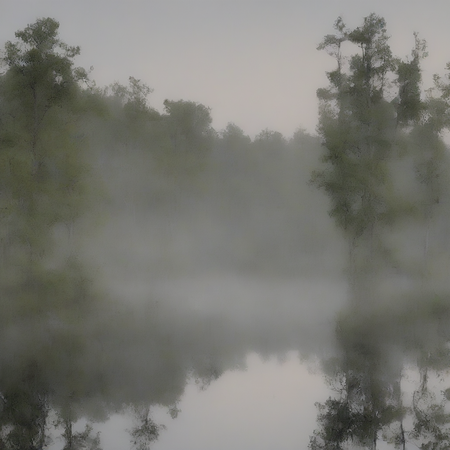
LUMORA style, a still lake surrounded by trees at dawn
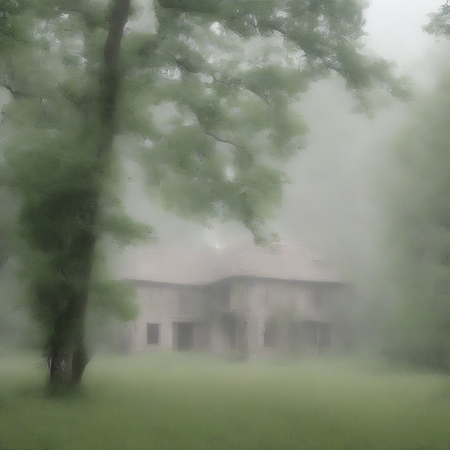
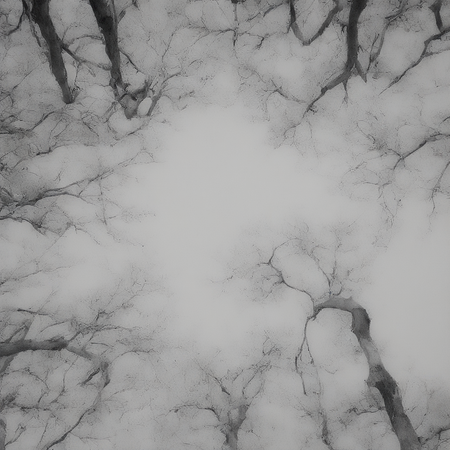
LUMORA style, an old building partly hidden by trees and soft haze / LUMORA style, a close-up of delicate branches against a sky
Комментарий
Модель усвоила несколько важных характеристик исходной подборки:
— Атмосфера и дымка. Наиболее убедительно передаются сцены, где туман объединяет объекты и постепенно скрывает детали.
— Приглушённая палитра. В части изображений сохраняются серо-зелёные и нейтральные оттенки.
— Мягкий свет. Рассеянное освещение и снижение контраста помогают воспроизвести характер исходных изображений. Светлые участки иногда почти сливаются с фоном, из-за чего появляется ощущение туманного пространства.
— Графичность контуров. В кадрах с ветвями и деревьями проявляется характерное соотношение тонких тёмных линий и светлого пространства. Этот эффект отличается от дымчатых пейзажей, но также связан с особенностями исходной подборки.
Из наблюдений:
Иногда, чтобы скорректировать результат, я меняла формулировки промптов, подробнее описывая желаемый фотографический характер изображения и приглушённую цветовую палитру.
— Сравнение итераций показало, что текстовый запрос заметно влияет на итоговую композицию и атмосферу, но не позволяет полностью контролировать характер текстуры.
— Разные сюжеты также дают разные результаты. Изображения с водой и туманом легче поддерживают задуманный визуальный язык, потому что мягкие переходы и отражения естественно сочетаются с исходной эстетикой. В более детализированных сценах, например с архитектурой или густой растительностью, чаще проявляются избыточная текстурность и повышение насыщенности.
Реализация
Базовая модель: Stable Diffusion XL 1.0
Метод адаптации: DreamBooth + LoRA
Размер датасета: 20 авторских фотографий
Формат исходных изображений: квадратный, 1:1
Среда обучения: Google Colab
Вычислительная среда: GPU T4
Триггер стиля: LUMORA
В первой версии ноутбука обучение было настроено на 500 шагов. Во время работы возникли проблемы с облачной средой: после отключения сессии временные файлы модели стали недоступны. Поэтому позднее был подготовлен облегчённый вариант ноутбука с поэтапным обучением и промежуточными контрольными точками.
В ходе эксперимента я также меняла промпты генерации, чтобы сравнить, как описания сюжета и фотографических свойств влияют на результат. Итоговая галерея представляет собой отбор наиболее удачных кадров из нескольких итераций.
Использованные модели и методы
- Stable Diffusion XL 1.0 — базовая модель для генерации изображений.
Ссылка: https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0
2. DreamBooth + LoRA — метод дообучения генеративной модели для адаптации к авторскому визуальному стилю.
Пример реализации для SDXL: https://github.com/huggingface/diffusers/blob/main/examples/dreambooth/train_dreambooth_lora_sdxl.py
3. BLIP — Bootstrapping Language-Image Pre-training — модель для автоматического создания текстовых описаний изображений. Она была предусмотрена в первоначальной версии ноутбука для подготовки подписей к исходному датасету.
Ссылка: https://huggingface.co/Salesforce/blip-image-captioning-base
4. SDXL VAE fp16-fix — вариант декодера VAE, использованный в первоначальной конфигурации ноутбука для работы с SDXL в половинной точности. Ссылка: https://huggingface.co/madebyollin/sdxl-vae-fp16-fix