AFTERIMAGE — эксперимент по обучению генеративной модели визуальному языку аналоговых изображений. В центре исследования — графические эффекты, возникающие при нарушении привычных условий формирования и воспроизведения фотографии: пересветы, размытые контуры, зернистость, шумы, цветовые искажения и следы повреждения носителя.
Проект исследует возможность воспроизведения этих характеристик без физической плёнки, химических процессов и фотографируемого объекта. Вместо изображения действительности нейросеть генерирует её предполагаемые визуальные следы.
Важной частью эксперимента становится противоречие между физическим происхождением аналоговых эффектов и их полностью цифровым воспроизведением.
Основная идея:
может ли нейросеть воспроизвести визуальные свойства аналогового изображения, если обучить её на текстурах, искажениях, пересветах и других эффектах, но не на конкретных объектах?
02 / Датасет
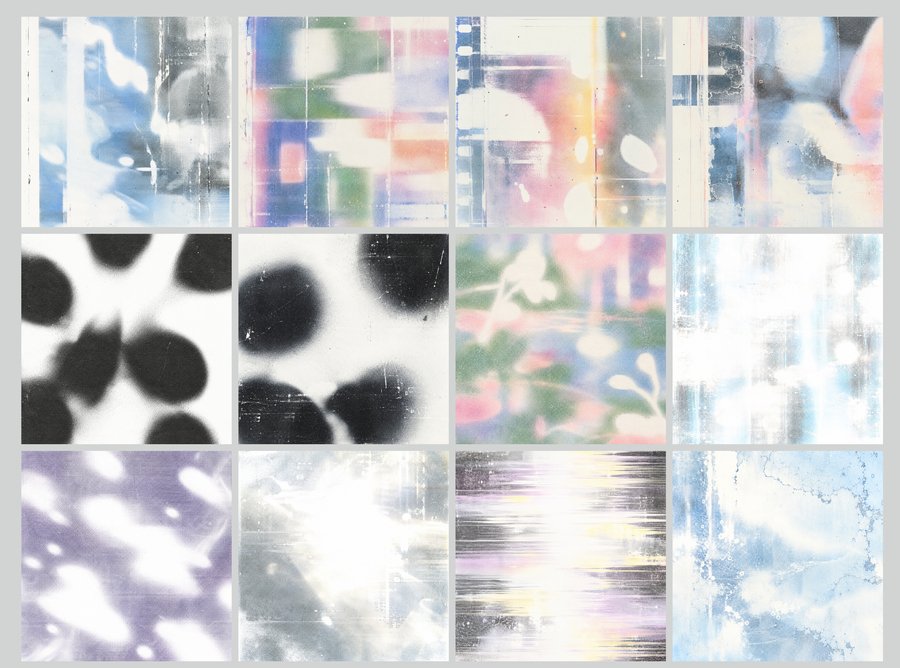
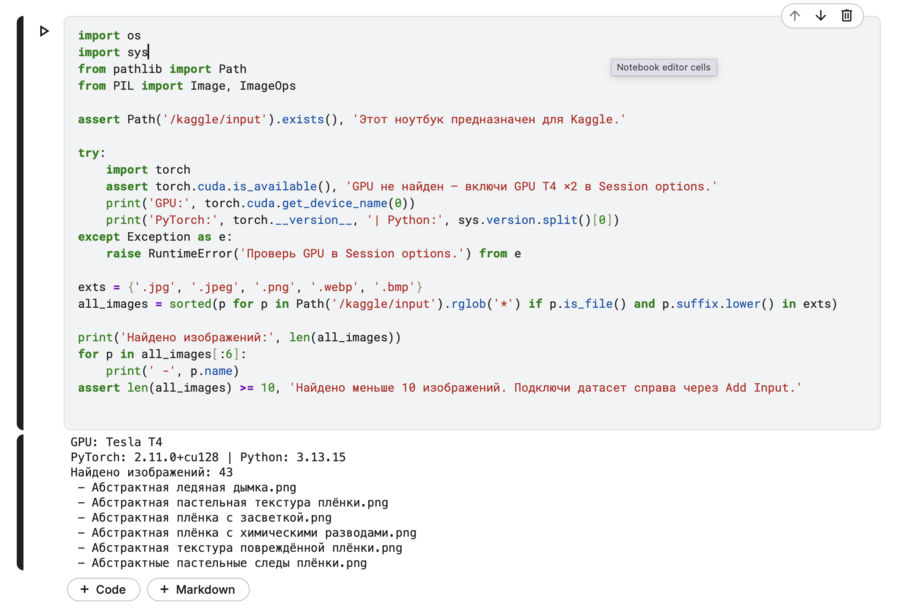
Исходный датасет из 43 изображений был создан с помощью генеративного искусственного интеллекта ChatGPT (OpenAI). Для генерации использовались текстовые запросы, описывающие различные графические эффекты.
Датасет содержит несколько разновидностей эффектов, от монохромных размытых силуэтов до светлых цветных текстур, напоминающих засвеченную плёнку и повреждённые фотографические отпечатки.
Материалы объединены общими визуальными признаками: ограниченной контрастностью, рассеянным светом, неравномерной зернистостью, абстрактными пятнами, нарушениями цвета и структуры изображения.
03 / Обучение модели
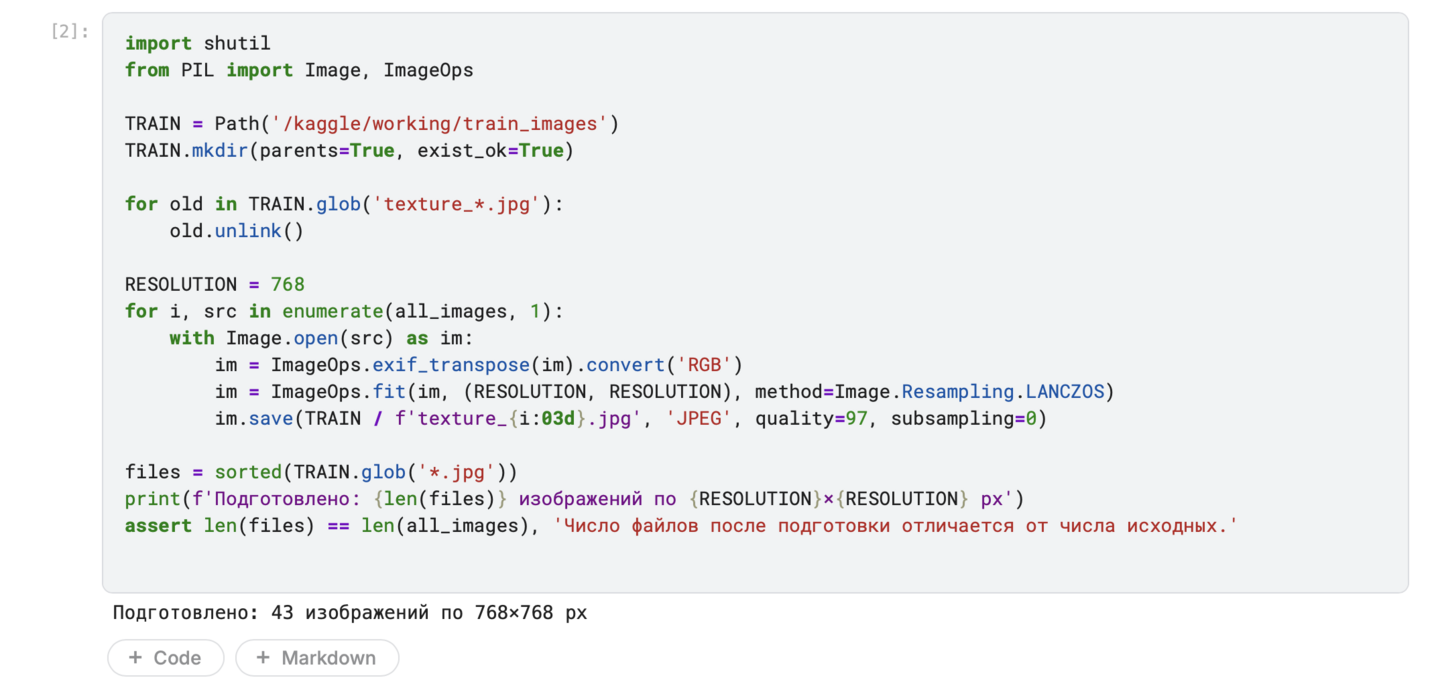
В качестве базовой модели выбрана Stable Diffusion XL 1.0. Для её адаптации использован метод DreamBooth LoRA, позволяющий обучать дополнительные параметры модели на пользовательском датасете без полного переобучения всей нейросети.
Обучение проводилось в среде Kaggle на графическом процессоре NVIDIA Tesla T4. В коде задавались путь к исходной модели, расположение обучающих изображений, разрешение, число шагов обучения и текстовый идентификатор нового визуального стиля.
Для вызова изученных характеристик использовался специальный токен zyvra, включённый в текстовое описание изображений.
Обучение проходило в течение 350 шагов. На каждом шаге нейросеть обрабатывала изображения из датасета, сравнивала результат своей работы с обучающим материалом и обновляла параметры LoRA.
Использовались смешанная точность FP16, оптимизатор 8-bit Adam и gradient checkpointing для снижения нагрузки на видеопамять.
После завершения обучения полученные параметры были сохранены в файле pytorch_lora_weights.safetensors. Он содержит обученную LoRA, которую можно подключить к базовой модели для создания новых изображений.
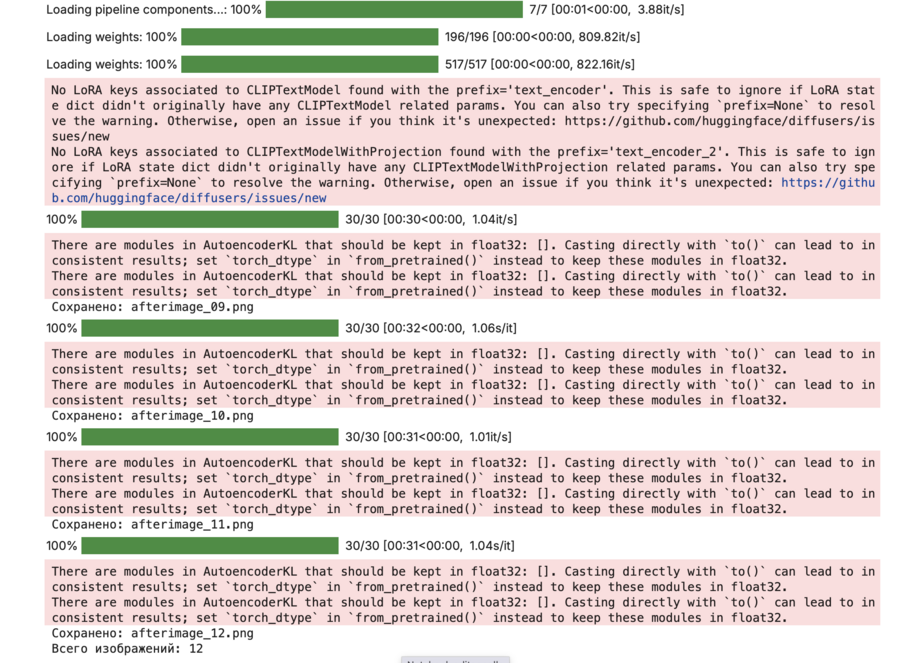
После обучения сохранённая LoRA была подключена к Stable Diffusion XL. Для генерации использовались текстовые запросы с токеном zyvra, описывающие различные характеристики аналоговых графических эффектов.
Запросы варьировались по цветовой гамме, форме световых пятен, плотности зернистости, степени размытости и характеру искажений. При этом сохранялась единая основа промптов, соответствующая визуальному языку обучающего датасета.
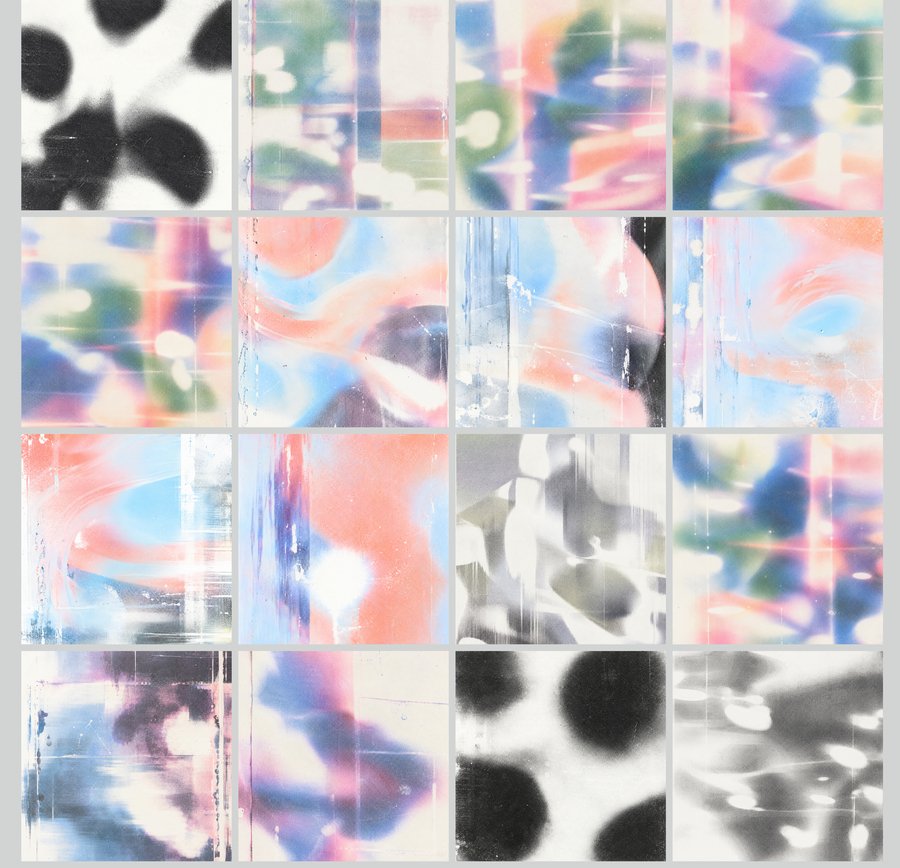
Генерация выполнялась с использованием 30 шагов инференса для каждого изображения. В итоге были получены 10 квадратных изображений размером 1024 × 1024 пикселя.
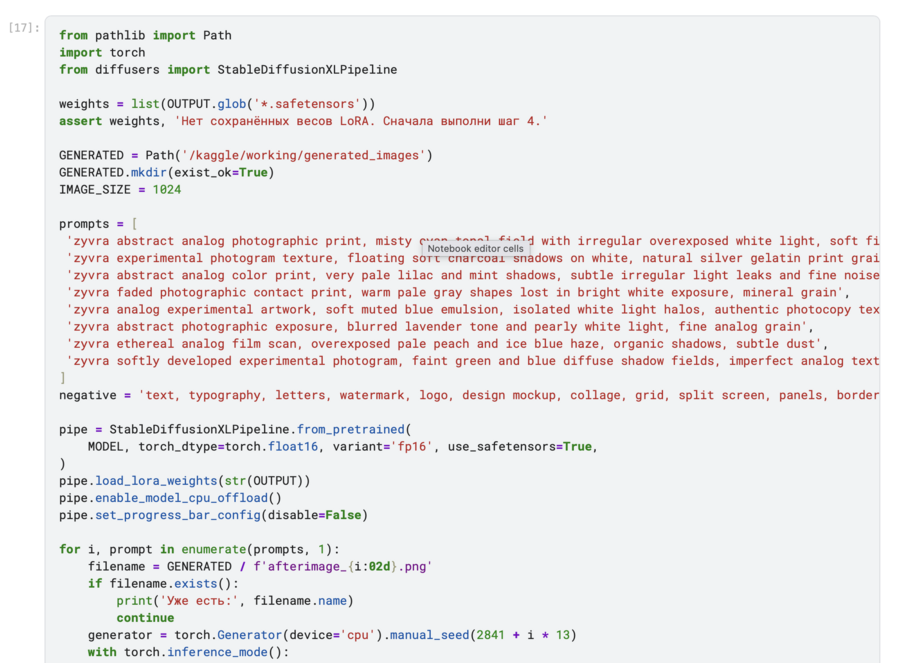
Основой запросов стала формулировка experimental analog photographic print texture. Дополнительные параметры позволяли изменять отдельные характеристики изображения: цветовую гамму, степень размытия, характер световых пятен, зернистость и распределение форм.
Например, в разных запросах использовались описания overexposed light leaks, blurred organic shadows, translucent haze и halftone glow. Таким образом, каждый промпт задавал новую комбинацию визуальных эффектов, сохраняя общий принцип генерации.
04 / Вывод
Исходный датасет был сформирован вокруг нескольких групп визуальных эффектов. При обучении задача заключалась не в воспроизведении отдельных изображений, а в передаче общих характеристик этого визуального материала. Основными признаками стали мягкие границы форм, неоднородность поверхностей, приглушённые цветовые сочетания и различные способы взаимодействия света с изображением.В генерации использовались разные текстовые запросы, благодаря которым можно было исследовать вариативность внутри обученного стиля. Важным аспектом эксперимента стало различие между аналоговым эффектом и его цифровой имитацией.Эксперимент позволил создать собственную LoRA на основе небольшого визуально объединённого датасета и использовать её для генерации самостоятельной серии изображений.Полученный результат представляет собой цифровую интерпретацию аналоговых графических эффектов, в которой особенности исходного материала становятся основой для новых визуальных комбинаций.
05 / Описание применения генеративной модели
Stable Diffusion XL 1.0 (Stability AI)Основная генеративная модель проекта. Использовалась для обучения на пользовательском датасете из 43 изображений и последующего создания итоговой серии из 12 изображений.Для адаптации применялся метод DreamBooth LoRA с использованием библиотеки Hugging Face Diffusers. Обучение проводилось в среде Kaggle, количество шагов — 350.Модель: https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0Метод обучения: https://huggingface.co/docs/diffusers/main/training/dreamboothChatGPT / генерация изображений OpenAIИспользовался при подготовке исходного визуального материала: генерации абстрактных текстур и экспериментальных графических эффектов, которые впоследствии отбирались для обучающего датасета. В процессе работы проводились последовательные изменения композиции, цвета, контрастности и характера фактуры.Конкретная версия модели генерации изображений при создании исходного архива не фиксировалась.Инструмент: https://help.openai.com/en/articles/11084440-images-in-chatgptПрограммная реализацияОбучение и генерация проводились в Kaggle Notebook на языке Python с использованием библиотек PyTorch, Diffusers, Transformers, Accelerate, PEFT и BitsAndBytes.